逐际动力张巍:如何“让霍金走路” | 一线课堂
嘉宾派 · 2026-11-12
2026年,具身智能迎来场景落地元年。作为这一赛道的百亿独角兽,逐际动力致力于成为“有AI驱动能力的主机厂”,通过大小脑融合技术让机器人在物理世界实现真正的自主行动。
1、教授创业“不靠谱”
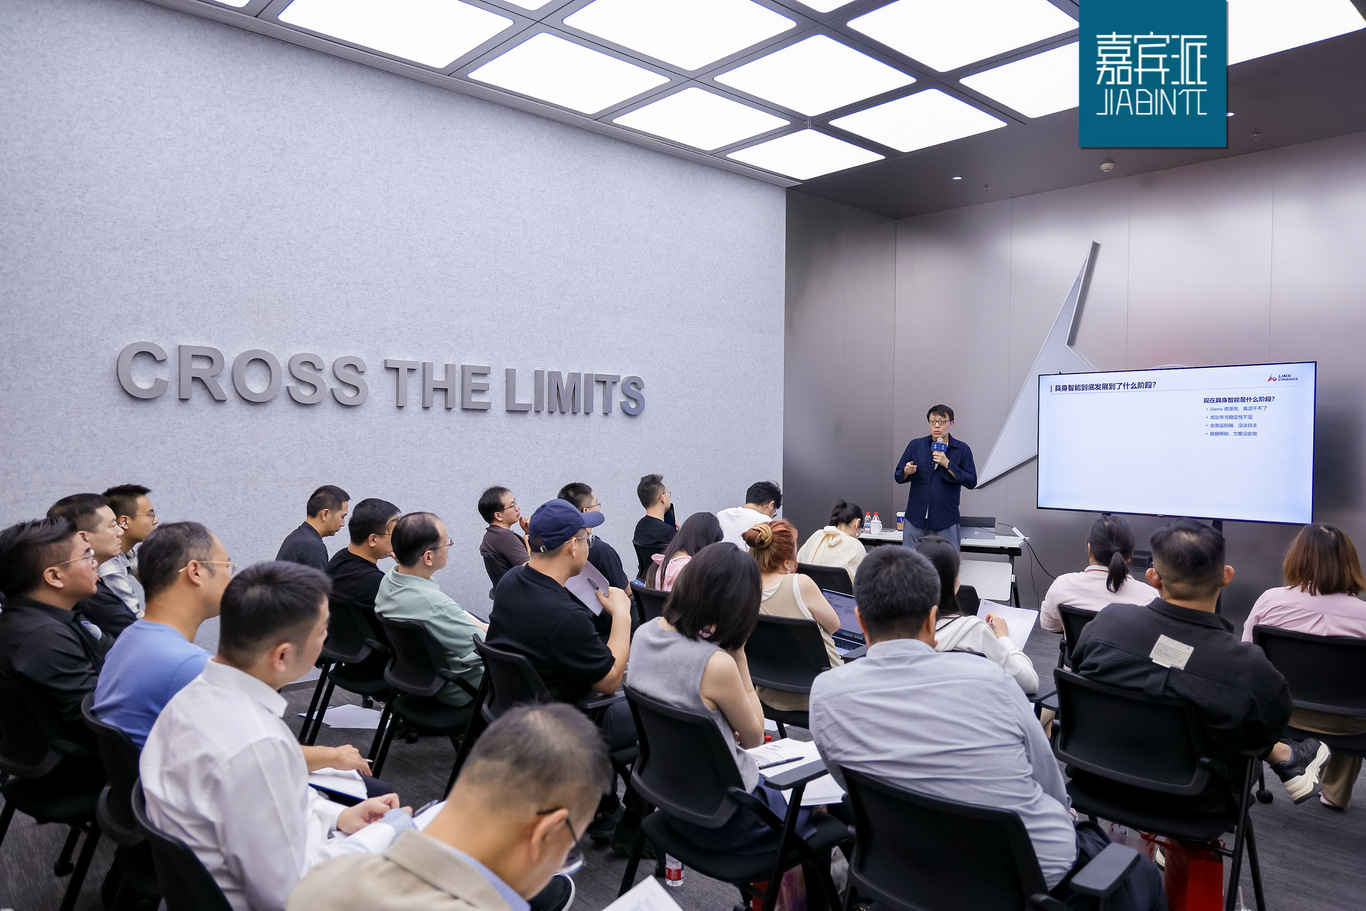
嘉宾商学的各位校友大家好,欢迎来到逐际动力。
我先坦白一件事:尽管我们已经开始了在建筑、大众体育、巡检等很多领域的场景验证,但逐际目前还是一家没有完成规模化、没有完成商业化的公司。所以,用一套成熟的商业化逻辑来评判逐际,是不太合适的。我今天能分享的,只是在这个赛道里,我们手上有一些技术先发优势的前提下,我们是怎么走过来的。
我是辽宁本溪人,读的是中科大。2003年去美国,待了16年。博士后期间在伯克利,无论是现在做 Physical AI 的,还是 OpenAI 创始团队,都是我们那时候相互交流的伙伴。后来我在美国当教授当了很长时间,2019年回国后任教于南方科技大学,2022年创办逐际动力。
先讲我的第一个观点,教授创业是不靠谱的。
教授是离商业化闭环最远的一类人,他需要转变思维,而这个转变要经历五个阶段。每一次转变,都是目标函数的改变,同时带来组织形式和人才审美的一次跃迁。
第一次,从学术思维出发。什么叫学术思维?天天在朋友圈说自己发了几个顶会论文,觉得很牛,以 idea 为荣。但想法离落地还很远。
第二次,跃迁到技术思维。很多所谓的思想家没有核心技术,做不出东西。技术思维是以 demo 为傲,天天秀 demo。
第三次,从技术思维到工程思维。demo大家都能做,但我做得比你稳定、可靠、100% 成功。这时候想象力反而有限了——工程思维不是一次展示,而是重复达到预期的能力。
第四次,工程思维能不能创造用户价值,这叫产品思维。
第五次,商业化。你会发现有很多产品,卖得越多赔得越多,越卖越赔。为什么?主要是商业化不行,没有完成闭环。
教授就站在这条链的最前端。所以我说,教授是离商业化闭环最远的行业。
那为什么这个行业里还有这么一伙人,大部分是教授,还有一些纯技术人员?因为这是一个技术突破所产生的新商业机会的落地,不是已有技术的商业落地。已有技术的商业落地,那是华为的事,纯商业化的人去做。我们这种是:现在看着没啥机会,但你会发现它未来可能打开新的机会,这伙人有一点前瞻性。
但他真正想落地,一定要往商业化那头跑,而且到了那儿还要反复练习——一个产品、一个产品,一个商业化设计、一个商业化设计地去练。我们才练了几个。我自己评,我都不算及格。思维是可以升级的,我们叫升维,但必须在这个过程里反复练。
我们 2022 年成立,一开始就是个大实验室。当年我们做了国内第一个带感知上楼梯的机器人,那时候国内没有人能干。但后来技术普及了大家都能干,从 demo 角度讲就是这样。中间做了很多探索,到了产品化的初期,我们主动做减法,聚焦到一个科研探索的小赛道。
为什么要走科研这条路?我用英伟达来举例,我认为英伟达是世界上最大的科研公司,它卖的就是科研。怎么理解?产品的属性,不是看产品本身,而是看使用者拿它去干什么。我们买英伟达的卡买好多,目的是探索;一旦我的模型成型了,不需要探索了,那不好意思,这些卡我就不需要了。
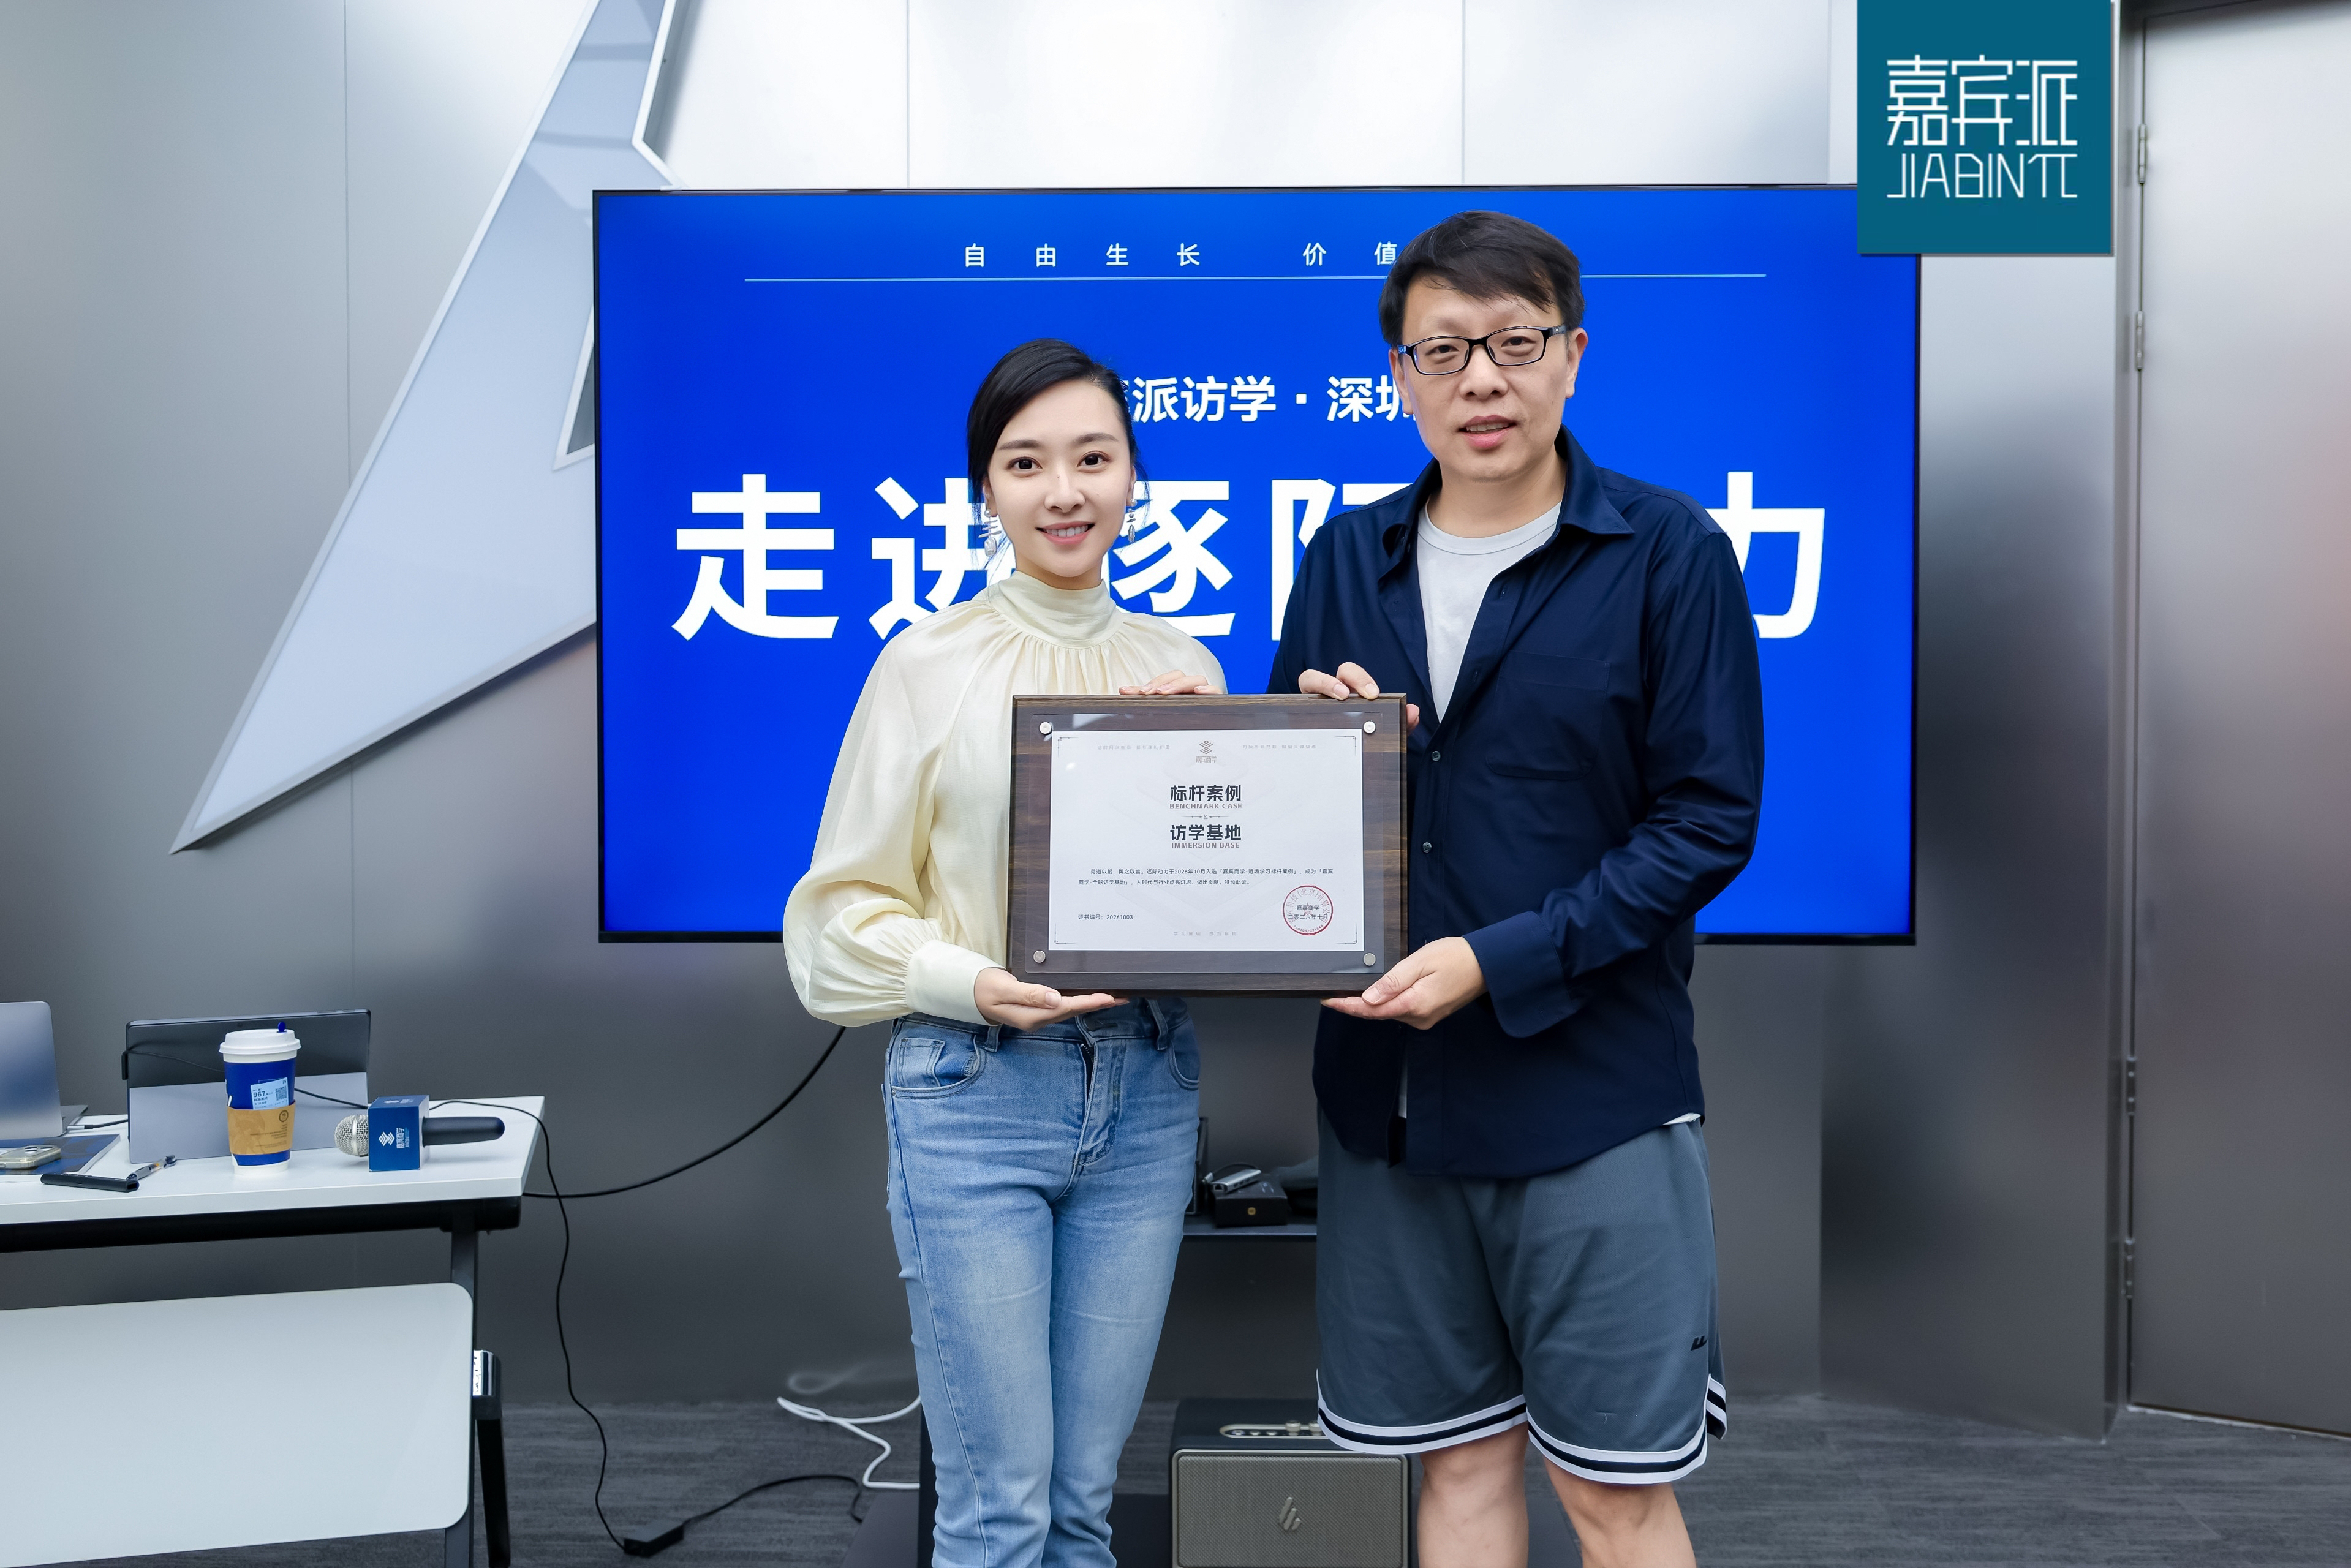
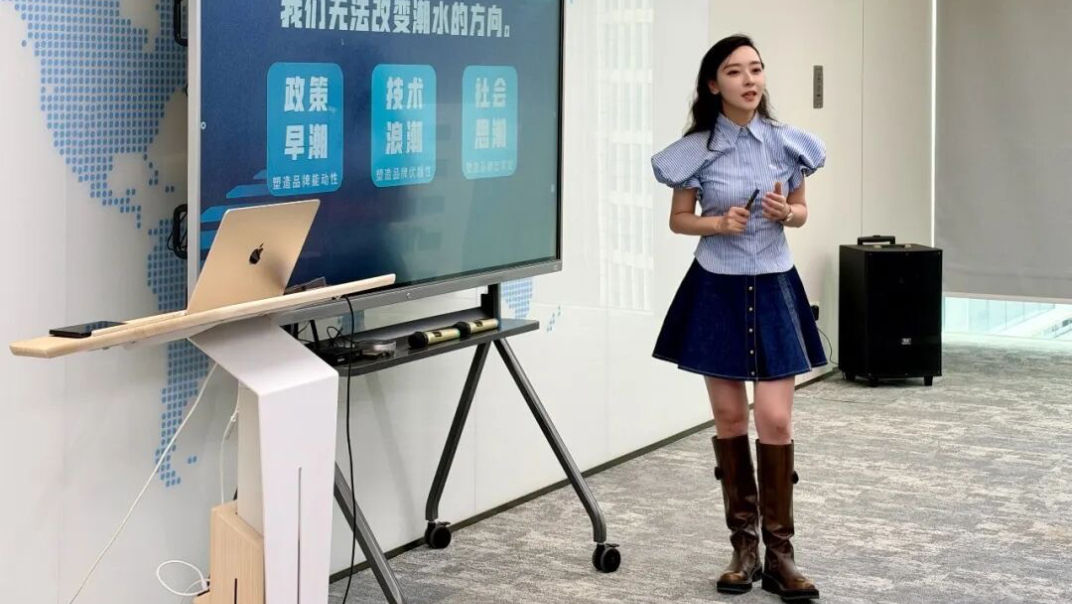
吴婷校长与张巍教授
我们大概经历了四个阶段:探索期→ 产品化初期 → 第一代产品 → 探索真正的商业化闭环。
其实 2017 年我们就开始做人形了,不是这个行业热了才做。2017 年在美国,一个只有下半身的机器人,当时卖 25 万美金一台,国内还买不到,坏一次要修两个月——这就是当时的迭代速度。
2021 年,我们是国际上第一个用端到端方案让人形在室外行走的。在此之前,波士顿动力都是用传统方案做翻跟头这些动作。但我要说的是:这个技术领先性,对商业转化没有什么效果。
反过来,特别懂商业化的人也有一个问题:他容易被技术的人、被教授魅惑,觉得他稀缺。
真正的能力是“能打”。这个赛道之所以卷,逻辑就在这里——这五层要揉在一个人身上。你想想,发明互联网的人,发明 TCP/IP 技术的人,在做这件事的过程中,他就要成为马云。按道理这俩不是一伙人。就像1980年代天天搞互联网技术研究的人,要变成马云、变成王兴,才可能成功。
这是我给大家的一个 lesson:以后不要被科学家魅惑。各位都是成熟的企业家,都有商业思维。
商业的竞争力永远不是技术,而是规模壁垒和用户壁垒。数据的规模、成本的规模、用户的规模,共同形成成本优势,其他没有了。技术只是这个产品当前的稀缺项,未来是非稀缺的。我们走了太多这种弯路了,所以跟大家说得比较坦诚。
2、具身是AI最重要的应用,没有之一
大家刚才提的问题里,好几个是同一类:现在是什么阶段?是不是该等一等、等它爆发?是不是还要五六年才能成熟?是不是鱼龙混杂?
先回答现象层面。现在大家看到的,用计算系统的话讲就是:demo 很漂亮,干不了活;看上去全靠遥控器,没法自主;数据稀缺。这些观察都是对的。
但要回答这个问题,得看这场变革的本质,要回到模型。
具身的发展不是硬件的发展,它是 AI 发展的应用,最重要的应用,没有之一。它把数字世界的 AI 搬到了物理世界,所以它必须 follow AI 的发展趋势。
从制造的维度看,人形机器人非常好做,你在市面上很少能找到比人形更好做的机器。机器人难落地,是因为缺物理 AI。物理 AI 比数字 AI 多了“物理”两个字,它能在物理世界获得数据;还多了“人形”两个字,人形的物理 AI 比非人形的物理 AI 要更复杂一点,大小脑融合的技术要更复杂一点。
从逻辑上讲,人脑是个非常简单的东西。首先要观念上蔑视它,才能真正理解它。脑是理解意图的:我看到一张图片,知道我全身的动作,我唯一要算的就是全身的关节怎么动。你想象写一个函数,这个函数的输入输出是非常清楚的,只是它处理的 case 太多了。
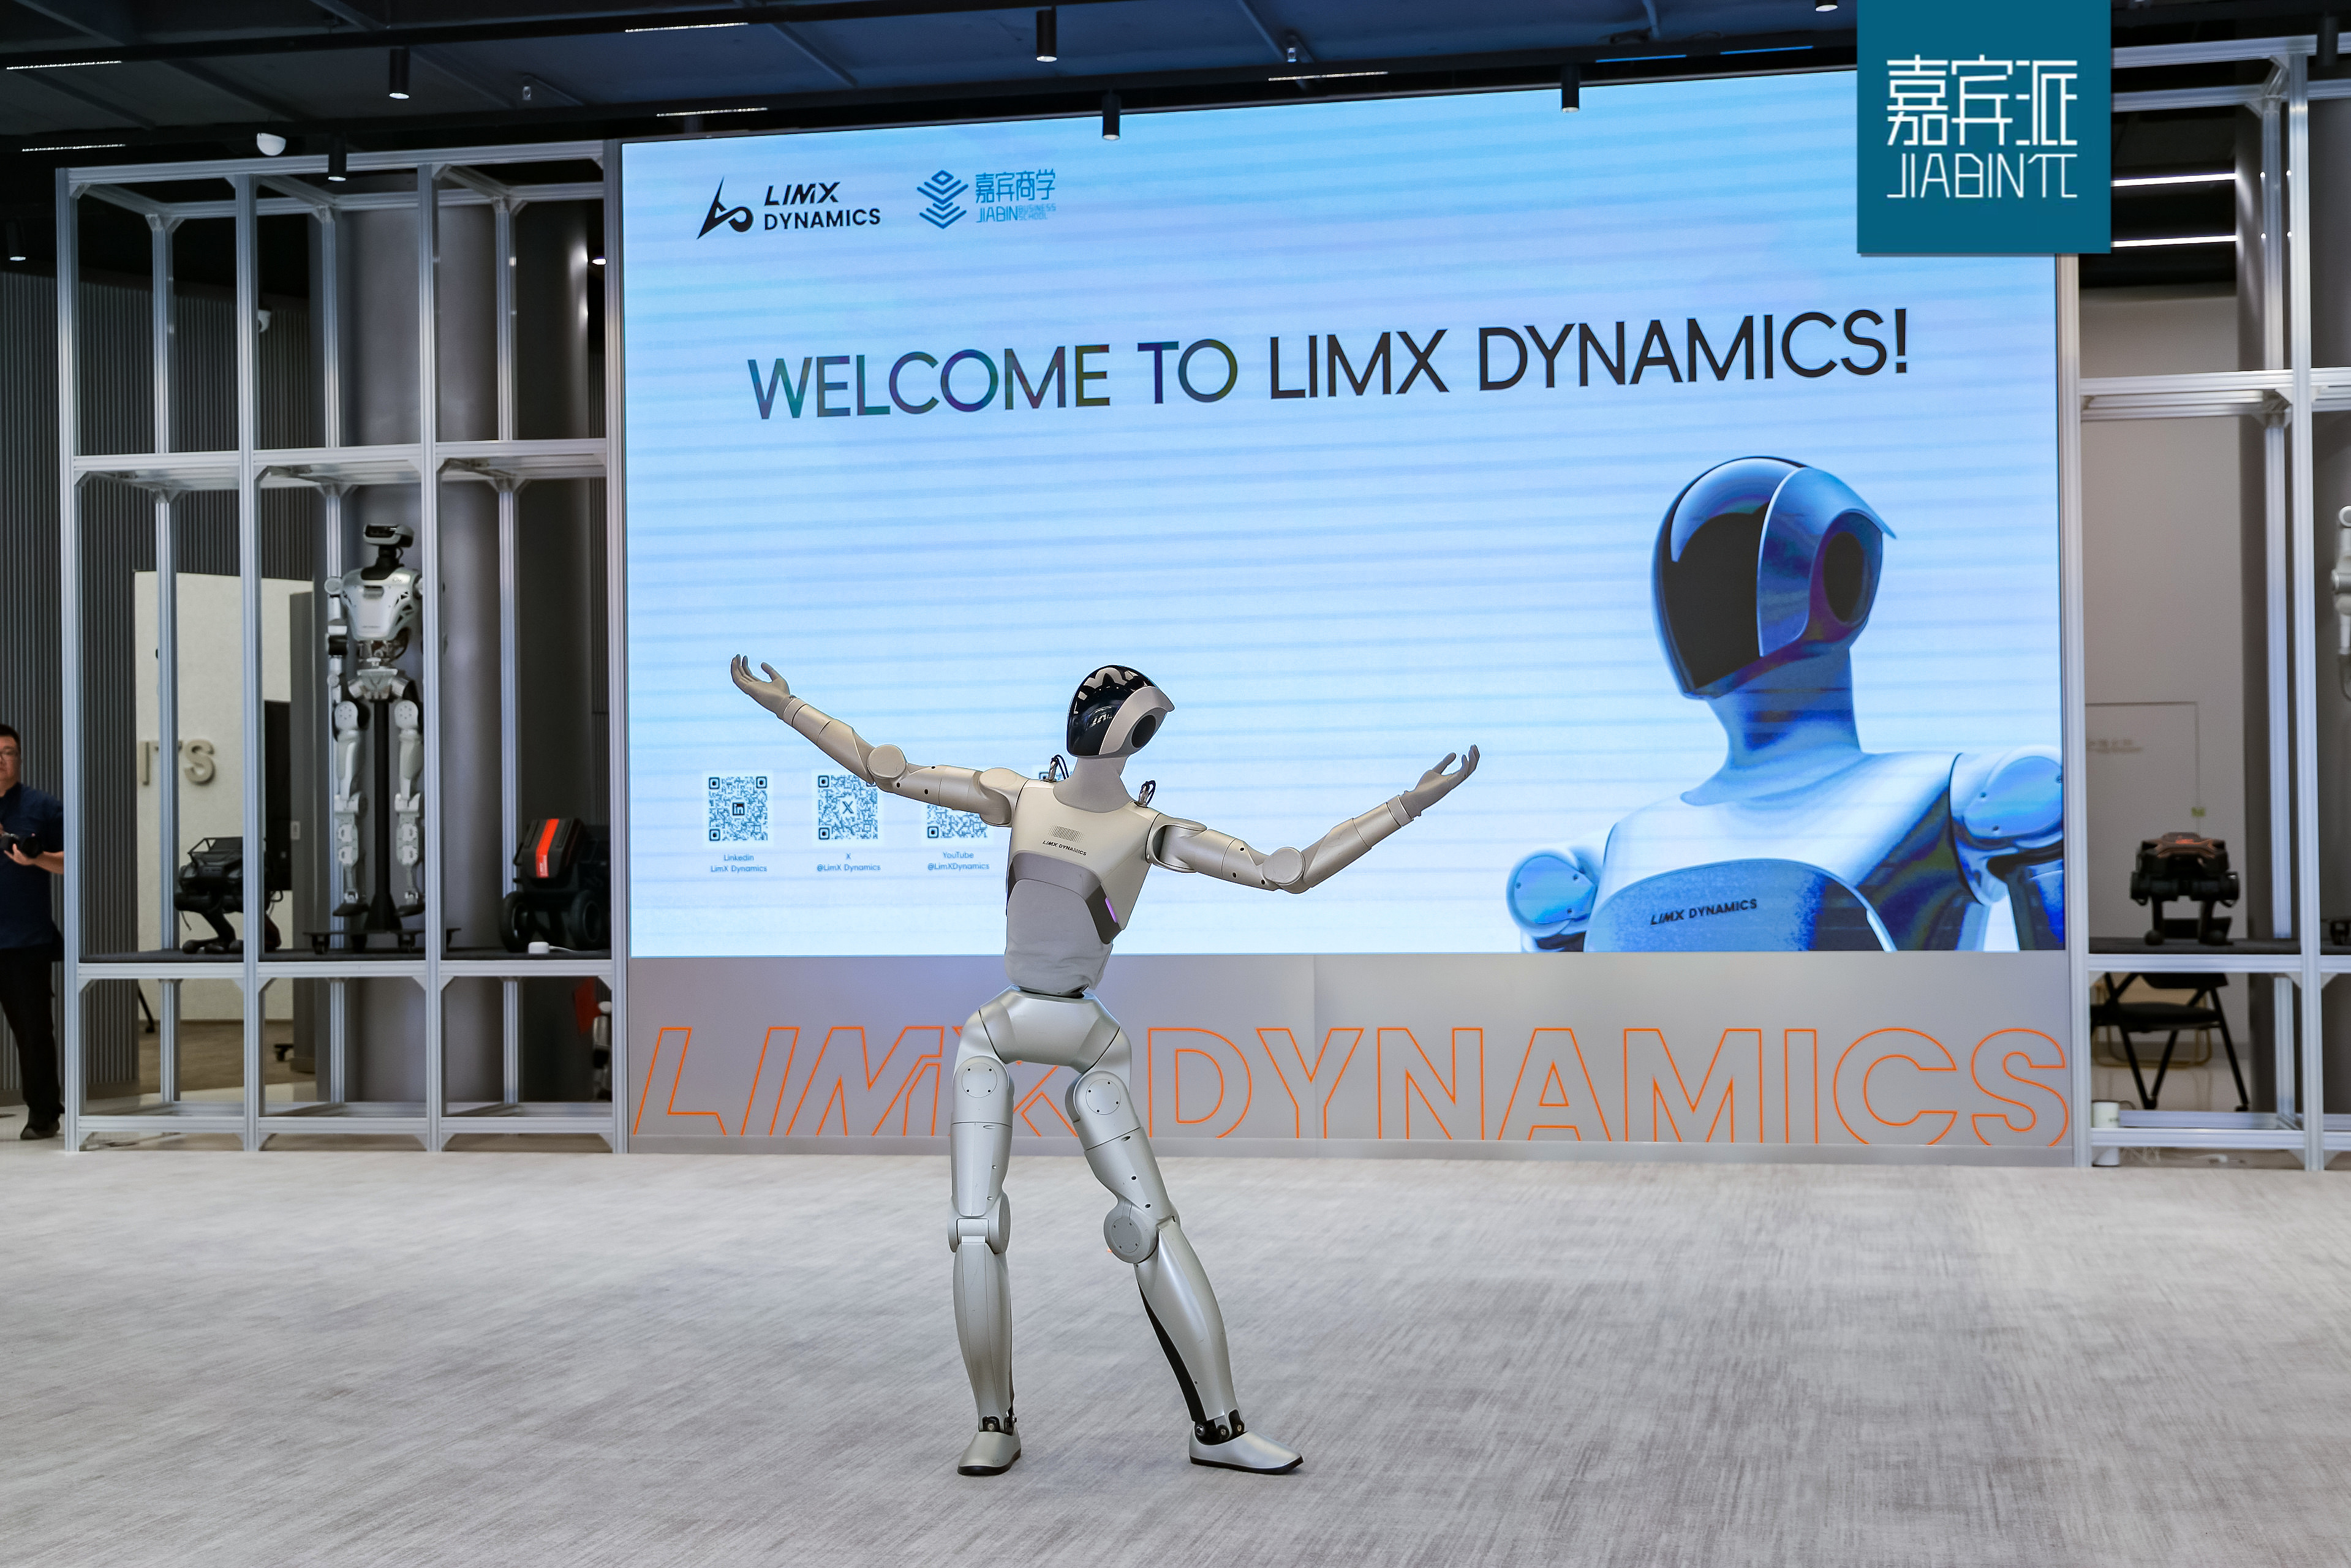
最近算力变得很贵,这不是模型本身的进步导致的,而是 agent 技术的成熟——从对话到自主完成任务,一轮一轮地跑。
agent 这个概念 2022 年就有了。有人说 2026 年成熟——错,应该是 2025 年 11 月。我认为 GPT-4.5 到 4.6 是一个巨大的变革点,之后才有了 OpenClaw,才有了“龙虾”,那是 agent 的第一个原型,才有了后面的这些东西。
现在提起“龙虾”都已经感觉是上个时代的事了,其实那就是今年一二月份的事,发展得非常快。
2024 年,模型侧在讨论 the wall,模型碰南墙,Sam Altman 还专门说“there's no wall”。
为什么大家觉得有个 wall?因为那时候会问:GPT-5 怎么还不来?它只能对话,agent 也总在犯错,应用已经接近上限。所以大家当时担心 AI 模型的发展,现在看,超出了大家预期。
这个误判的本质是什么?是大家用预训练的范式来评估智能的发展水平,而忽略了后训练和 agent 新范式。
具身也是类似的。你不能用线性的方式去推演。
这个时代的变革,不是数字模型到物理模型的变革,而是数字 agent 到物理 agent 的变革。绝大多数行业内的人都在讲模型的变革,我认为是agent的跃迁——从执行预编程动作、拿遥控器,到全自主,只有这样才能真正代替人。
这个变革是两年还是三年,不确定。但变革的本质是:数字世界的智能体走向物理世界的智能体,而且这个变革正在发生,不需要等额外的模型成熟。
有人问后面具身行业会死掉多少家。我认为不会死太多。
具身不是大模型,它有很多垂直(vertical)的应用场景,尤其有些 to B 的,很难完全死掉。它可能活得没那么大,但确实很难死。
3、大脑系统已经成型
刚才很多同学问:技术没收敛,我怎么办?
这个我的看法跟大家不太一样:技术方案很多,但范式已经收敛了。
GPT-3 的时候收敛了吗?当然收敛了。那时候还不入局,不就晚了吗?GPT-3 到3.5 用了两年半,做的是什么?工程、数据,最终才做出一个应用,就是 ChatGPT,后来才有 agent 。
所以数据驱动的范式已经非常清晰,只是应用还不够。
所有具身公司竞争的只有一件事:如何降低获取智能数据的成本。只要数据足够多,所有的智能都可以成立。只是人类还没搞清楚怎么从数据到智能,而现在数据太难获得了。
所以你看这个行业眼花缭乱:今天才了解真机遥操数据,明天就有什么 UMI,后天讲 ego-centric,再后来是世界模型,一大堆名词。都在干什么?本质上都在不断降低数据收集的成本。这是唯一的标准——成本低了就可以。
为什么我说大脑系统已经成型了?逐际有一个大脑系统,叫 COSA,我们大概分三层。我认为接下来真正第一个规模化商业落地的量,就要靠这个大脑系统的成熟。
首先,我们跟行业最大的不同是:我们认为模型不是大脑。模型是能力,大脑是一个多模型协作的系统。
人脑也是分区的——所以我们才有大小脑、才有各种区域:prefrontal cortex 前额叶,visual motor cortex 视觉运动皮层。每个区域是不同的,每个区域需要不同的数据来训练。
我们犯的最大的一个错误,是把模型的泛化能力当成了智能的衡量水平。我认为这是不对的。
大脑是一个系统。这个系统里最关键的是 System 2——本质上是以语言模型、视觉语言模型和世界模型为引擎的思考引擎。我写一下:LM、VLM,还有现在流行的 world model。
我用一个比喻来说明这三层的关系。
第一层,以语言模型为引擎的思考模型,是一个盲人,而且残疾。不是霍金,是又盲又瘫。他很聪明,能对话,你问他啥他都能说,但他看不见。
第二层,以 VLM 为推理引擎的,是不瞎的残疾人——有眼睛了。
第三层,以 world model 为引擎的,才是霍金。他学了一点物理,知道物理应该怎么演化,能在脑子里想,但也只是想。
这个脑什么时候有的?我强调,是 2025 年 11 月中旬,GPT-4.6 的时候,这个脑才真正打通。那之前引擎太差了,这个机器是开不起来的。能开起来以后,慢慢往前走、不断迭代,那是另一回事。我们今年初发了整个系统,是早于“龙虾”的。龙虾做的是数字世界的脑,我们做的是具身的脑,我们要让“霍金”康复。
大家看过病人怎么康复吗?你得拉着他动,动多了他就会干了,这跟我们的真机遥操没有本质区别。
所以康复的时候,你先学拿水还是先学走路?都可以。你的康复运动,决定了你能恢复什么。
霍金可能现在还不会拿东西,但你不能说他没有脑。我们现在可以做到一个会走路的霍金、会跳舞的霍金。现在主要的问题是:这个霍金能不能找到工作。其实非常可以,关键是把遥控器去掉。
这里我强调一个点,这是我个人独创的说法:具身的落地,技能和脑的智能是完全两个事。没有技能的泛化能力,不代表没有自主能力。这两个一定要分开,我可以不会开车,可以不会修电视,但不能说我没有脑。
技能的泛化是一个方面,它取决于你投入什么数据去练。自主性才是落地最核心的关键,而不是技能的泛化性,自主性主要是这一套系统的能力。
System 0 就是支撑所有上面这些的基础 foundation model。
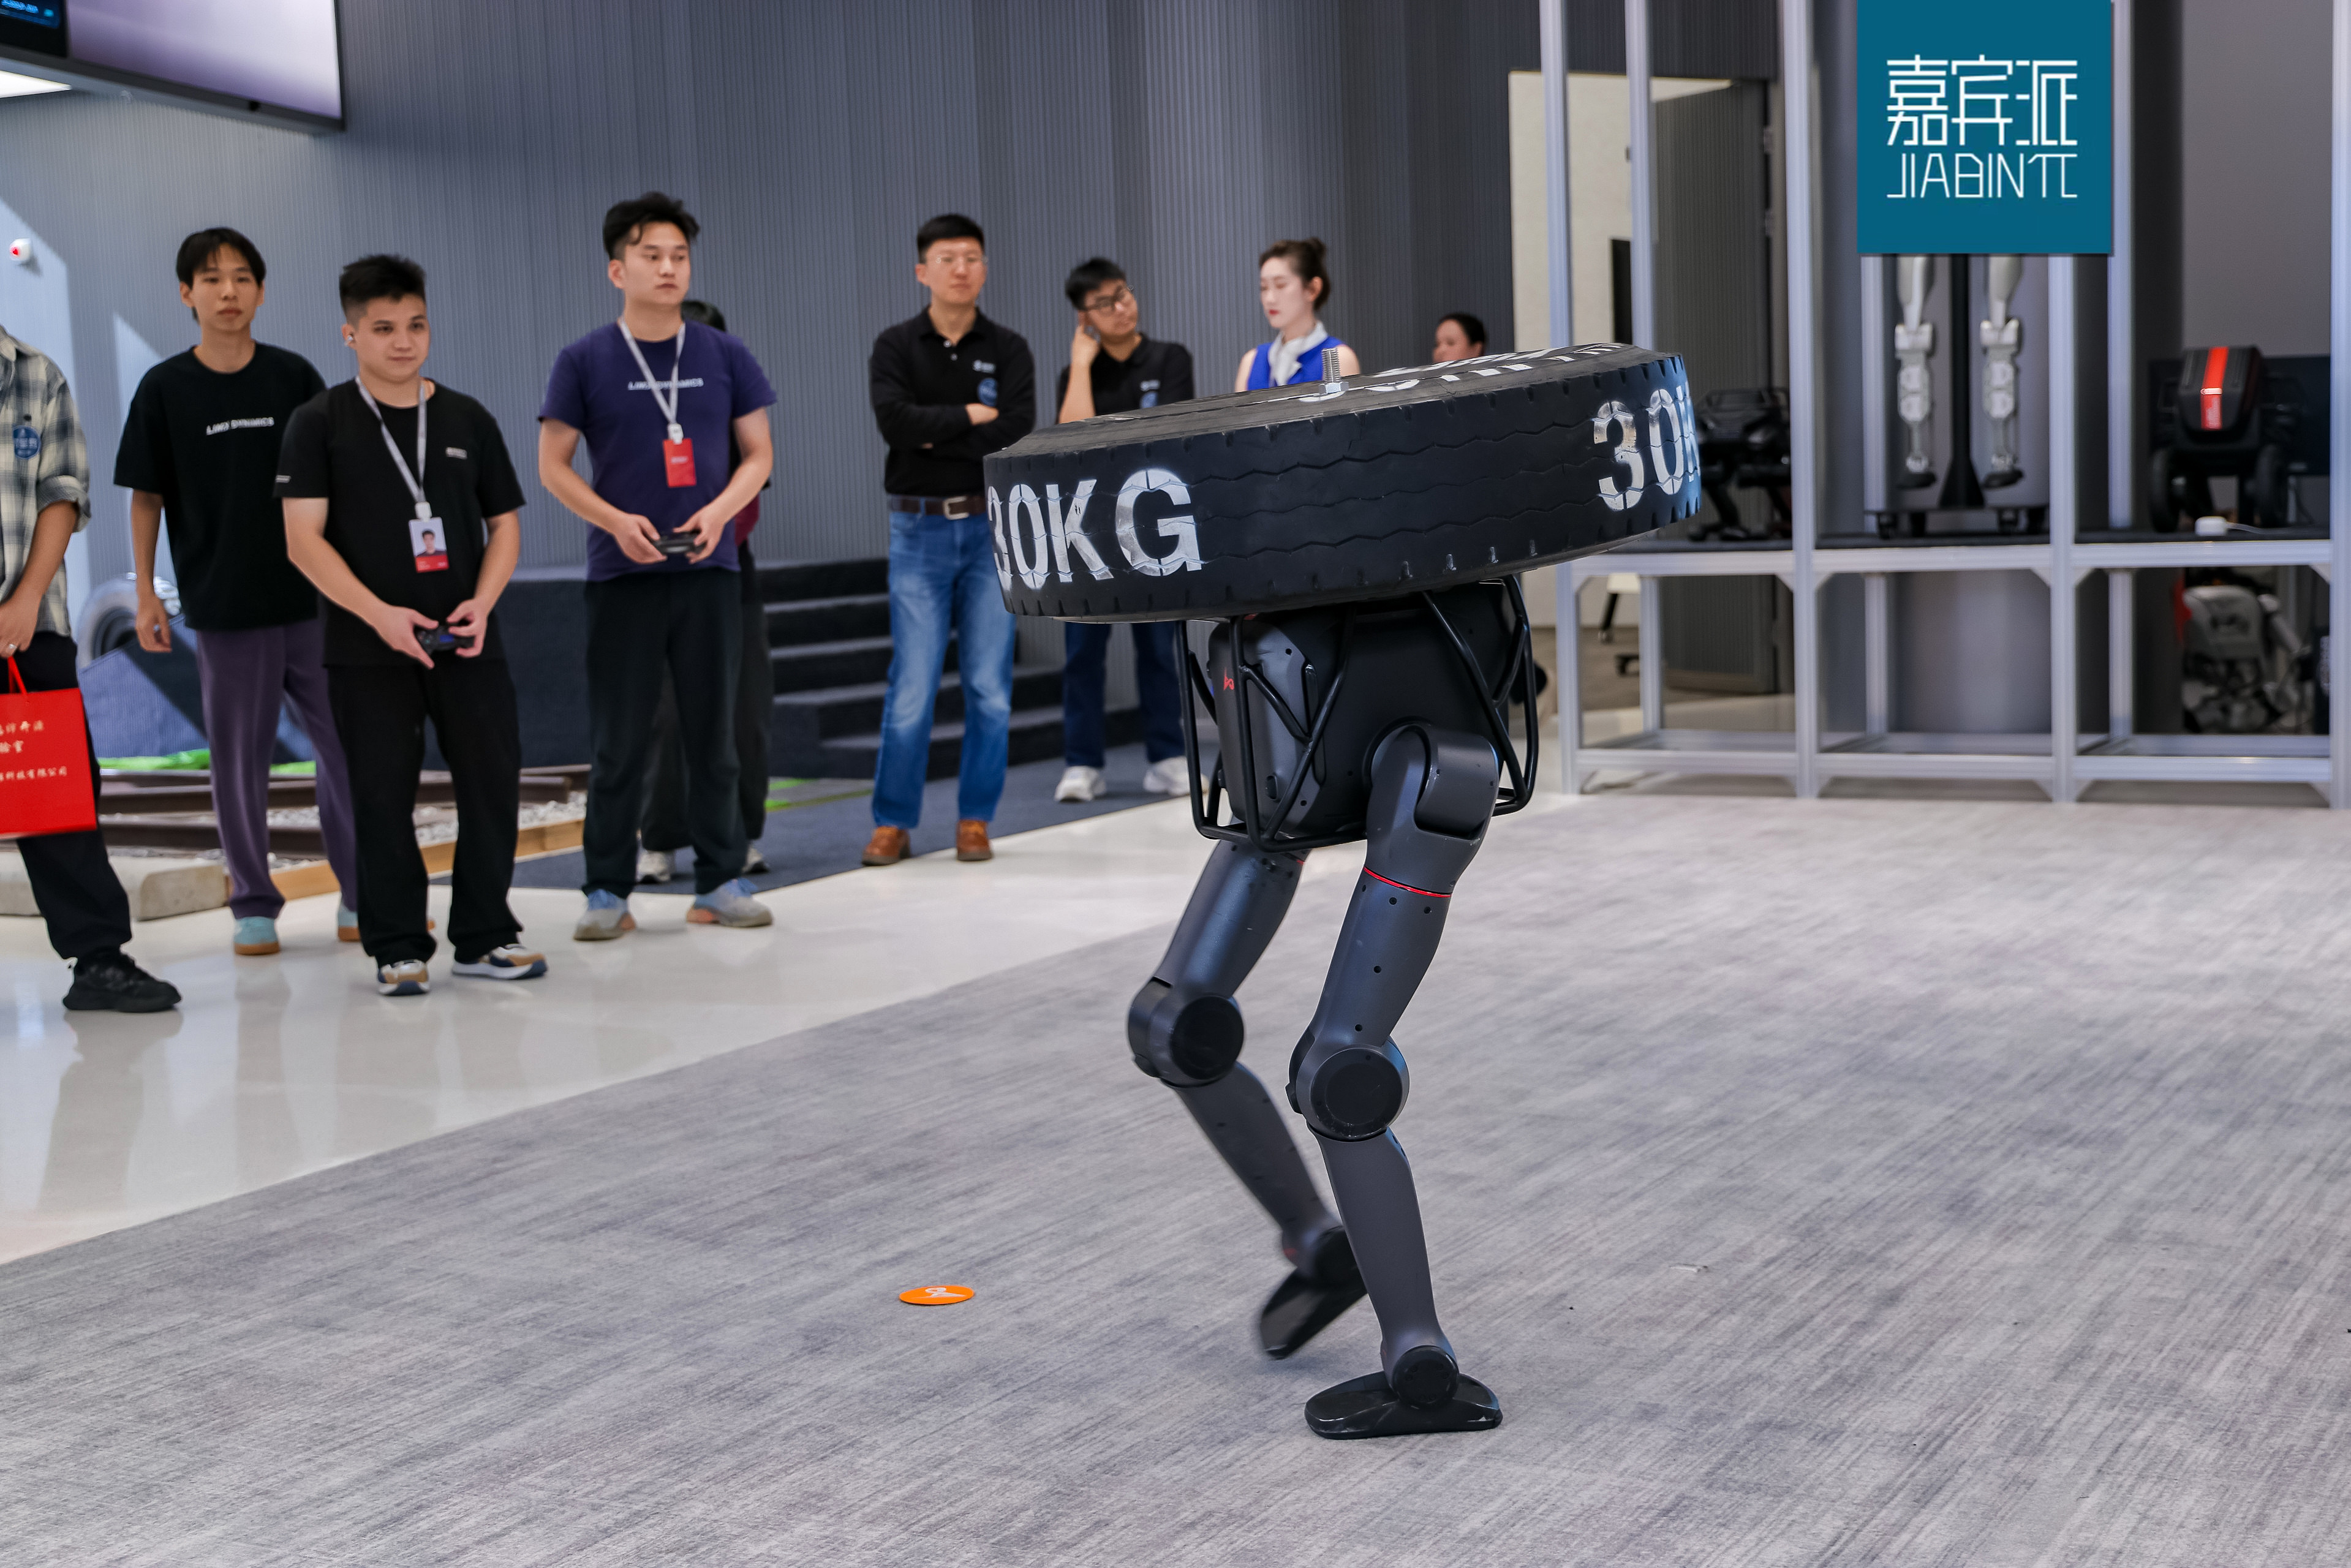
逐际是最早研究这个的,我们叫 agentic OS,具身的大脑系统。这里面每一层都有人在做,但我觉得最关键的,是把这几层连起来。思考指引行动,我们叫大小脑融合技术,这是我们主打的技术壁垒。
大家看到很多机器人跳舞,那个不是 System 0,不是小脑的基础模型,那个叫 Replay。就是你编好了一段动作,让它在保持平衡的前提下完成。这是一个重播的过程,不是基础模型。
什么是基础模型?事先不知道要怎么动,我实时产生的行动意图,你都能跟随它,这才叫基础模型。逐际在这个方向上是比较早的,做得也相对比较好。它最终代表的是 System 1 和 2,这是 0 和 body 的关系。
比如我现在看到这瓶水,我想去拿它,我不能回去再训半天、replay 一次,我要实时把它生成出来、执行掉。这就是小脑的基础模型。
2024 年我们跟 Figure 比过,Figure 当时(估值)3000 亿。同时期我们(技术)跟 Figure 差不多,后来他投入太大了,机器到处跳火坑、跳熔炉,你们看到了吧。我想说的是,这些都还是小脑基础,没有打通大小脑。
真正高阶的技能,是 System 1 的技能——从“看到”到“行动”。
先看盲走:闭着眼睛走,只保证不倒,踩到哪儿都行。但它其实不是一个稳定可靠解决问题的方式,它一定会倒,绊一下就会倒,所以它不是成熟方案。
我们从 2023 年底就开始一步一阶地做大小脑打通。现在“哪都能走”这件事已经可以做到,这个技能主要靠仿真和 Sim 2 Sim/信息流的技术完成。最关键的是:训练这个技能要靠数据驱动,而不是靠专家驱动。
去年我们还拿了个广州塔登塔第一名,是世界纪录,之前没有的。这就是带感知的、用感知指引行动、完成闭环的技能,相对还是稀缺的能力。
我们今年初发布 COSA,整个大脑系统。这是霍金刚康复,还有点晃,得拄双拐,但这不重要。大家一定要能看到技术进步的本质:哪些是可以通过堆钱堆人改进的,哪些是真的能力。
技术实现从 0 到 1,接下来要让它做得更稳定可靠,我不需要专家,我只需要收数据。这就把一个模型研发的活,转化成了一个体力活。你只要这个跑通了,剩下就是收数据、训练、部署,结束。
4、逐际动力的定位
人形(机器人)跟车厂差不多:核心零部件→ 技术解决方案提供商 → 代工厂 → 主机厂。
主机厂其实分两类:有大脑研发能力的主机厂,和没有大脑研发能力的主机厂。相当于有智驾算法团队的主机厂,和要外采智驾算法的主机厂。逐际要做的,是有 AI 驱动能力的主机厂。
中美的具身竞赛,我觉得中国会赢,比电动车的优势还大,我不觉得特斯拉有特别大的机会。

逐际的差异化定位是什么?第一,我们是有 AI 驱动能力的主机厂。第二,我们有个 slogan 叫 Serve people, not process——我们的人形是服务于人的,而不是在工厂里做流程。
因为现在这套从数据到训练、到具身数据训练的范式,更适合泛化性要求强、不确定性高、容差度高、精度要求不高的场景,也就是家庭和商业,不太适合工业。
工业里不能说完全没有具身的场景。但现在大家看到的、具身落地在工业里的,大部分还用传统技术,只是样子上像个具身,其实跟这一代大模型技术是不一样的。这一代具身更重要的是泛化性,而不是效率。
人形商业化的底层逻辑,我管它叫“通用本体+”,硬件平台要足够通用,来承接 AI 发展所带来的新功能叠加。
所以它有个特点:光有本体的时候没啥用,只能卖点科研。当有一个 APP ,比如只能跳舞,你会觉得比较鸡肋,好像没啥用。跟手机一样,如果只能打电话,那我好像也不需要买这么贵的。
但是,如果可以不改变通用硬件来叠加功能,当 APP 足够多的时候,会出现一个“吸星大法”的拐点:到那以后,所有的功能都会在这上面沉淀,它就不需要别的东西了。所以人形这个形态,一定要多用。不一定是通用,至少要能覆盖多个功能。
所以我说,我们是可以造人的。这个人就是会走路的霍金。剩下就是技能:先让他干什么?先学什么?
我们有个第一性原理,叫具身落地的牛顿定律:构建技能所需要的数据成本,小于技能本身的价值,就能落地。
我们始终觉得,落地的本质是:你希望他长什么技能?你是先学开车,还是先做别的。这跟养孩子差不多:你是先让他练钢琴,还是先让他打螺丝?你选什么,取决于投入产出比。都得花时间,都得花成本。
比如叠衣服,如果叠衣服非常简单,它可以部署,那也能赚钱;可如果现在花一个亿去训练叠衣服,而它光靠叠衣服赚不到钱,这就是问题。
所以我们更强调的是技能,而不是脑。模型本质上提供的是技能的泛化性。
我们把 2026 年定义成“场景落地的元年”——是开头,但不是爆发。
今年的重点是看场景落地,无论是场景落地的数据,还是场景落地的可能性,都是看这个,而不是看技术突破。
用刚才的定义讲,现在到了“长技能”的时候。大脑系统已经有了,那要让系统用起来,第一个能赚钱的技能是什么?
不能因为很多人做,就证明它没用;也不能说很多人不做,就有用,这不矛盾。
分享几个真实的落地信号:
逐际动力创学营。我们就在附近组织了一个线下黑客松,全国来了很多学生,大多是大一、研一的,还有本科生,全都是非具身专业的。三天时间,把市面上流行的所有 VLA、VAM 算法全部部署明白了,还上真机摸过了。所以我说,技术没有太大的壁垒——叠个衣服以前能融两个亿,我们三天大家都会了。你们感兴趣也可以学。这是一个 AI 时代,是赋能创造者的时代。
巡检与配送。有些客户拿它去做简单巡检,这是 demo 样机;跑通一些 POC、PMF 之后才会规模化往前推。今年很多订单来自非平整路面的巡检和配送。
地面拍摄专机。我们跟优艾智合很快要做一个跟踪地面拍摄的专机,我觉得非常有市场。
高动态发球陪练。最近参加了比利·简·金杯,动态的高动态发球——这不是我们做的,是合作伙伴在上面加东西。他们的发球机是全球出货量第一,现在要往自主陪练发展:传统发球机是抛物线式地“嘣”一下发出去,动态不够;这个要跑到前面啪一下,发出一个非常漂亮的球,最后还要跳发,这会给我们一些批量订单。
文娱 IP。比如恐龙,四川自贡这个产业挺大的,他们在往上探索。
我们的机器才发货不到几个月,已经有很多用户把它用起来了,这是个比较好的信号。也有一些小批量的规模化订单。他们跑通一个东西,就会多订一些。所以我们的做法是:把平台做好,把接口做好,底层的创新者在里面做尝试。
我们发现,具身落地,你光给个机器不行——落地的场景集成方和场景方,他们不会用。所以我们开源了怎么去训练这些模型,都告诉大家。最终是平台加接口,他们在场景里采数据、落地,形成小的闭环。
关于行业的商业化,我不认为会立刻是大家想象的那种“进家庭”,那是几万亿的事。但至少百亿营收的赛道是有的,就看你怎么干。
其实 100 亿在具身这块非常小:20 万一台,卖 5 万台就够了。只要打透一个场景,基本上就可以做到百亿营收。百亿营收在这个赛道里,就可以活得比较好。
时间上:今年是起点,明年是 POC、PMF 验证通过,后年爆发。当然,现在没有人可以说确定,说确定也不合理。
至于技术,操作泛化的稳定性和可靠性提升,我觉得不会特别久,大概两三年、三四年;技术到产品落地,可能再要两三年、三四年。
人形通用形态,我觉得未来国内不会超过 10 家——因为它相对通用。真正能够围绕用户去迭代技术的,才能活下来。
出品|嘉宾商学